GPT 图像 · Image API
直接指定 gpt-image-2 出图与改图:generations 与 edits 全参数、b64_json 与 url 双形态响应、4K 最高画质实测样图、蒙版编辑
POST /v1/images/generations · POST /v1/images/edits
GPT 图像有两套入口,这一套是默认入口:直接指定图像模型一次性生成或编辑,size / quality 按请求执行,
4K + high 约 50 秒返回。另一套是 Responses——gpt-6-astra 调度 image_generation 工具做对话式多轮编辑,
但它拿不到高分辨率与高质量档位,只在需要多轮对话时使用。
协议与 OpenAI Image API 兼容,openai SDK 把 base_url 换成 https://www.vibeapi.cn/v1 即可。
本页结论来自对本网关的真实调用,最后验证:2026-09-12。
基本调用
curl -X POST "https://www.vibeapi.cn/v1/images/generations" \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2",
    "prompt": "a red apple on a wooden table, studio lighting",
    "quality": "medium",
    "size": "1024x1024",
    "response_format": "b64_json"
  }'
from openai import OpenAI
import base64, urllib.request
client = OpenAI(base_url="https://www.vibeapi.cn/v1", api_key="YOUR_API_KEY")
result = client.images.generate(
model="gpt-image-2",
prompt="a red apple on a wooden table, studio lighting",
quality="medium",
size="1024x1024",
)
item = result.data[0]
if item.b64_json:
image_bytes = base64.b64decode(item.b64_json)
else:
image_bytes = urllib.request.urlopen(item.url, timeout=60).read()
open("apple.png", "wb").write(image_bytes)import OpenAI from "openai";
import fs from "fs";
const client = new OpenAI({ baseURL: "https://www.vibeapi.cn/v1", apiKey: "YOUR_API_KEY" });
const result = await client.images.generate({
model: "gpt-image-2",
prompt: "a red apple on a wooden table, studio lighting",
quality: "medium",
size: "1024x1024",
});
const item = result.data[0];
const imageBytes = item.b64_json
? Buffer.from(item.b64_json, "base64")
: Buffer.from(await (await fetch(item.url)).arrayBuffer());网关上的图像模型
图像生成分散在三个端点上,先确认你要的模型走哪一个:
| 模型 | 端点 | 文档 |
|---|---|---|
gpt-image-2 · gpt-image-2.5-1k · gpt-image-2.5-flare · gpt-image-2.5-sunburst | /v1/images/generations · /v1/images/edits | 本页 |
gemini-3-pro-image · gemini-3.1-flash-image · gemini-3.1-flash-lite-image(含 -preview) | /v1beta/models/{model}:generateContent | Gemini 图像生成 |
grok-imagine-image-2.0 · grok-imagine-image-quality | /v1/images/generations · /v1/images/edits | Grok 图像 |
wan3.0-image-* | /v1/videos(图生视频,不是出图) | 视频生成 |
Gemini 的生图必须走原生端点:走 Chat 兼容协议能出图,但 imageConfig(画幅、分辨率)会在协议转换中丢掉。
wan3.0-image-* 名字里带 image,指的是「图生视频」,它走视频接口。
本页只讲 gpt-image-2。gpt-image-2.5-* 系列当前未在 /v1/models 与价格页列出,开放后会补到这里。
与 Responses 怎么选
| Image API(本页) | Responses | |
|---|---|---|
| 端点 | /v1/images/generations、/v1/images/edits | /v1/responses + image_generation 工具 |
| 调用模型 | gpt-image-2,直接指定 | gpt-6-astra,内部调度图像模型,无法指定 |
size / quality | 按请求执行,4K + high 精确返回 | 被改写:要 4K/high 实得 1536×1024/medium |
| 耗时 | 4K + high 约 45–57 秒 | 40–170 秒 |
| 提示词优化 | 无 | 自动,返回 revised_prompt |
| 多轮编辑 | 不支持,每次独立 | 支持,上下文携带图片 |
| 参考图 | multipart 文件上传 | URL / base64 / file_id |
| 返回 | data[0].b64_json 或 data[0].url,两种都要处理 | SSE 事件里的 base64 |
要高分辨率、高画质、准确尺寸,用本页;要对话式多轮,用 Responses。
generations
全部请求字段:
| 字段 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
model | string | 是 | — | gpt-image-2 |
prompt | string | 是 | — | 图片描述文本 |
size | string | 否 | auto | 见输出定制;3840x2160 / 2160x3840 精确返回 |
quality | string | 否 | auto | low / medium / high / auto,按档执行 |
output_format | string | 否 | png | png / jpeg / webp;以响应顶层字段和文件 MIME 为准 |
output_compression | integer | 否 | — | 0–100,仅 jpeg / webp |
response_format | string | 否 | — | b64_json / url;不决定响应形态,见下文 |
moderation | string | 否 | auto | auto / low |
background | string | 否 | opaque | opaque / auto;transparent 不支持,会被忽略 |
n | integer | 否 | 1 | 无效,恒返回 1 张;多张请并发 |
stream / partial_images | — | 否 | — | 不要依赖;同步调用即可 |
响应有两种形态
同一个端点,data[0] 里可能是 b64_json(内联 base64),也可能是 url(临时下载链接,有时效,拿到后尽快下载)。
response_format 传了也不保证——generations 传 b64_json 通常拿到内联数据,edits 传相同值仍可能返回 url。生产代码必须两种都处理:
import base64, urllib.request

item = result.data[0]
data = (base64.b64decode(item.b64_json) if item.b64_json
        else urllib.request.urlopen(item.url, timeout=60).read())
open(f"out.{result.output_format or 'png'}", "wb").write(data)
if jq -e '.data[0].b64_json' response.json >/dev/null; then
jq -r '.data[0].b64_json' response.json | base64 --decode > out.png
else
curl -L "$(jq -r '.data[0].url' response.json)" -o out.png
fi响应顶层的 size / quality / output_format 是实际值,请读它们并校验下载后文件的真实 MIME:
{
  "created": 1789190861,
  "data": [{ "url": "https://..." }],
  "output_format": "png",
  "quality": "high",
  "size": "3840x2160",
  "model": "gpt-image-2",
  "usage": { "input_tokens": 234, "output_tokens": 13342, "total_tokens": 13576 }
}
edits
POST /v1/images/edits (multipart/form-data)两类场景:用一张或多张参考图生成新图;配合蒙版重绘指定区域。表单字段与 generations 相同,另加:
| 字段 | 类型 | 说明 |
|---|---|---|
image[] | file,可多个 | 参考图。多张时重复 image[] |
mask | file | 蒙版,可选。须含 alpha 通道,透明区即重绘区,与原图同尺寸、不超过 50MB |
多参考图:
result = client.images.edit(
    model="gpt-image-2",
    image=[open("ref1.png", "rb"), open("ref2.jpg", "rb"), open("ref3.jpg", "rb")],
    prompt="Combine the subjects into a single flat-lay collage on white marble, studio lighting",
    quality="medium",
)
curl -X POST "https://www.vibeapi.cn/v1/images/edits" \
-H "Authorization: Bearer $API_KEY" \
-F "model=gpt-image-2" \
-F "image[]=@ref1.png" -F "image[]=@ref2.jpg" -F "image[]=@ref3.jpg" \
-F "prompt=Combine the subjects into a single flat-lay collage on white marble" \
-F "quality=high" -F "size=3840x2160" > response.json蒙版编辑:
result = client.images.edit(
    model="gpt-image-2",
    image=open("base.png", "rb"),
    mask=open("mask.png", "rb"),       # 透明区即要重绘的区域
    prompt="In the masked area, add a blooming cherry blossom tree",
    quality="low",
)
多张参考图时蒙版作用于第一张。蒙版是提示性的:模型以它为引导,不保证严格贴合形状。 edits 对整体风格和构图的保持很强,对局部小对象的加入偏保守——要求「加两只鹤」这类小元素可能不出现,先用自己的图试一次。
输出定制
size 官方约束:最大边不超过 3840px,两边均为 16 的倍数;长短边比不超过 3:1;总像素在 655,360 ~ 8,294,400 之间。
常用 1024x1024、1536x1024、1024x1536、2048x2048、3840x2160、2160x3840、auto。
3840x2160 与 2160x3840 均精确返回;仍建议读响应顶层的 size 做校验。
quality low / medium / high / auto。high 按档执行,可用 usage.output_tokens 核对:4K 高清档约 13,300,中间档约 3,300。
output_format png / jpeg / webp,配合 output_compression(0–100,仅 jpeg / webp)。始终以响应顶层 output_format 和下载文件的 MIME 为准。
background gpt-image-2 不支持透明背景,传 transparent 会被忽略,输出不透明图片:
n 无效,恒返回 1 张。多张请并发多次调用,或用 Responses 在提示词里要求多张。
实测:4K 最高画质
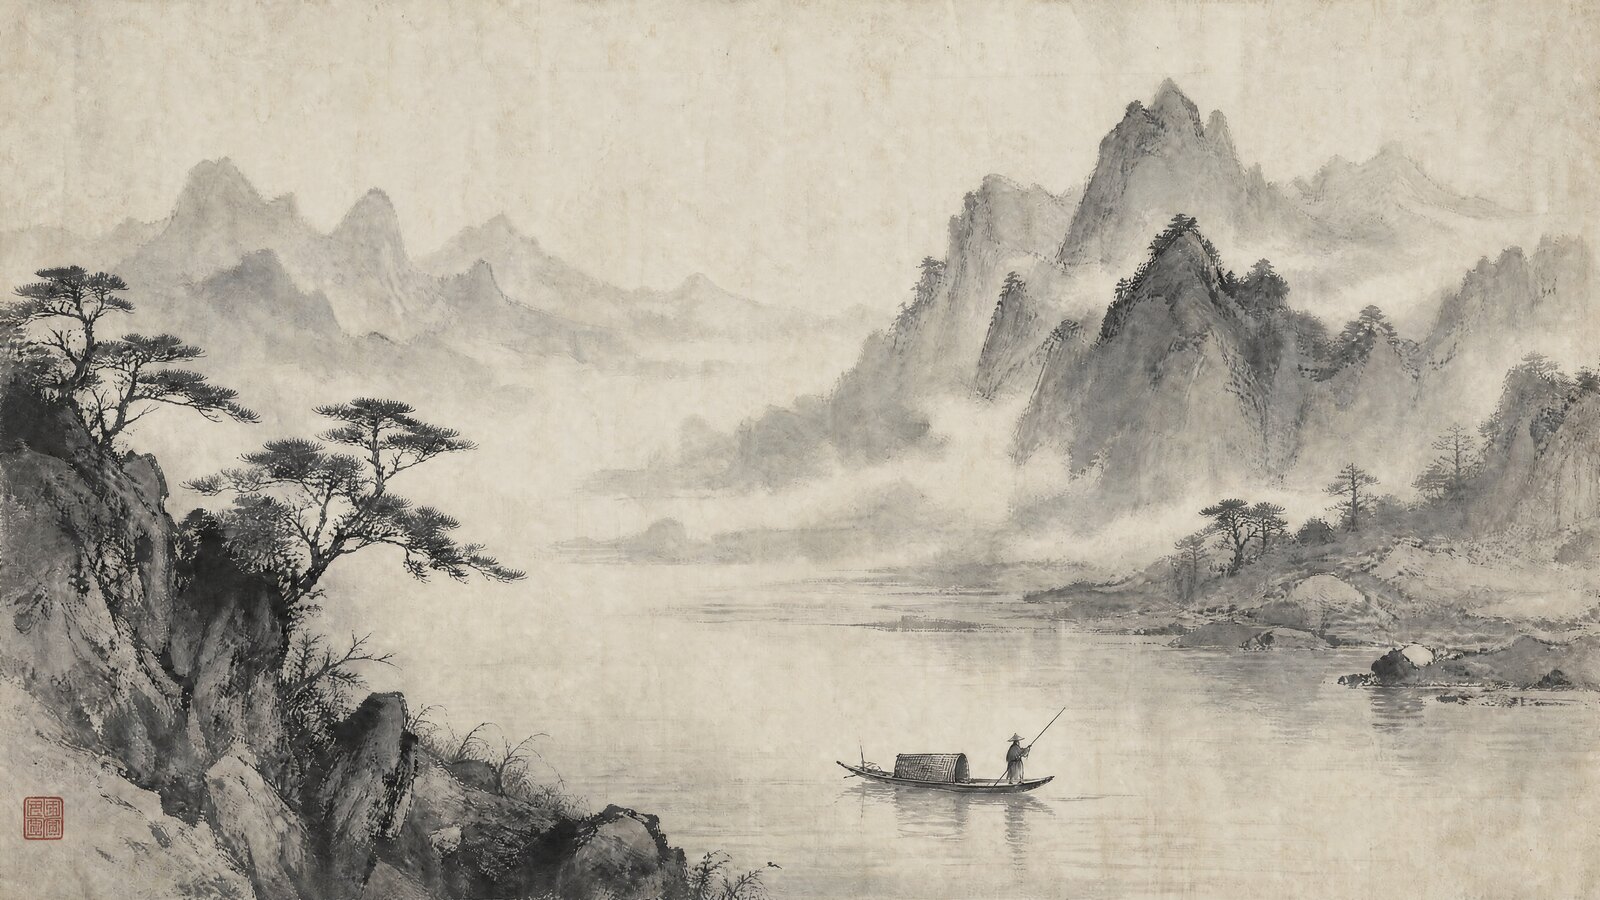
quality=high,size 取官方上限 3840x2160 / 2160x3840,六个主题并发 6 路:
| 主题 | 请求 size | 耗时 | 实返 size / quality | data[0] | output_tokens |
|---|---|---|---|---|---|
| 东方水墨 | 3840x2160 | 52.0 s | 3840x2160 / high | url | 13,342 |
| 仙侠 | 2160x3840 | 56.7 s | 2160x3840 / high | url | 13,342 |
| 工笔重彩 | 3840x2160 | 54.1 s | 3840x2160 / high | url | 13,342 |
| 环形空间站 | 2160x3840 | 47.6 s | 2160x3840 / high | url | 13,342 |
| 巨构城市 | 3840x2160 | 54.1 s | 3840x2160 / high | url | 13,342 |
| 戴森云 | 2160x3840 | 45.2 s | 2160x3840 / high | url | 13,342 |
六张全部按请求尺寸返回真实 4K PNG(9–17 MB),无一超时。
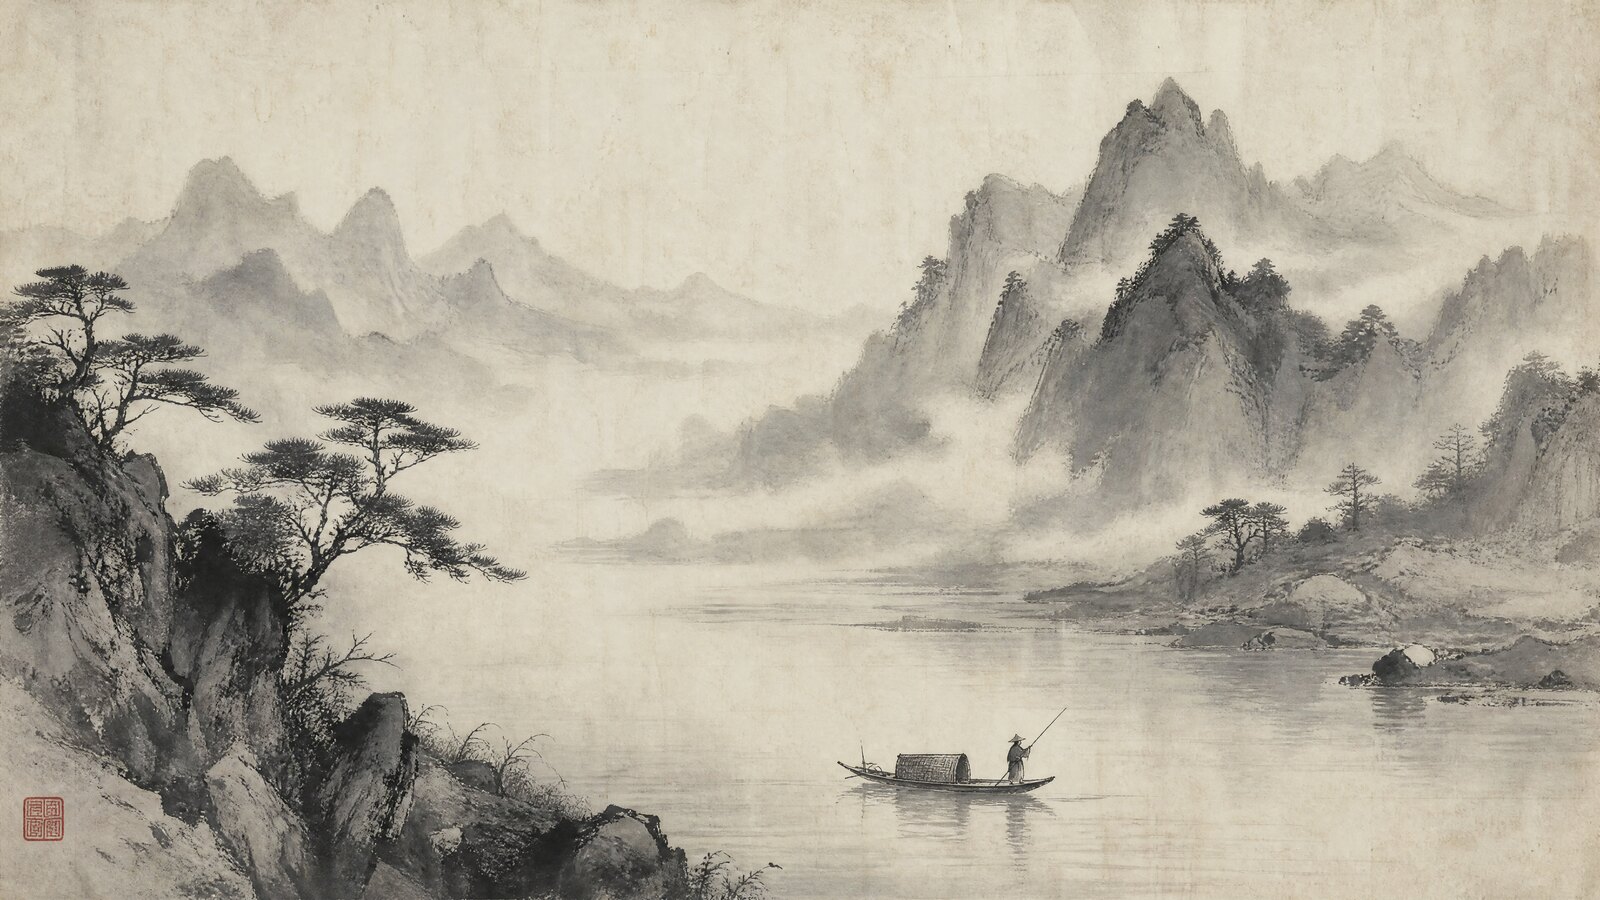
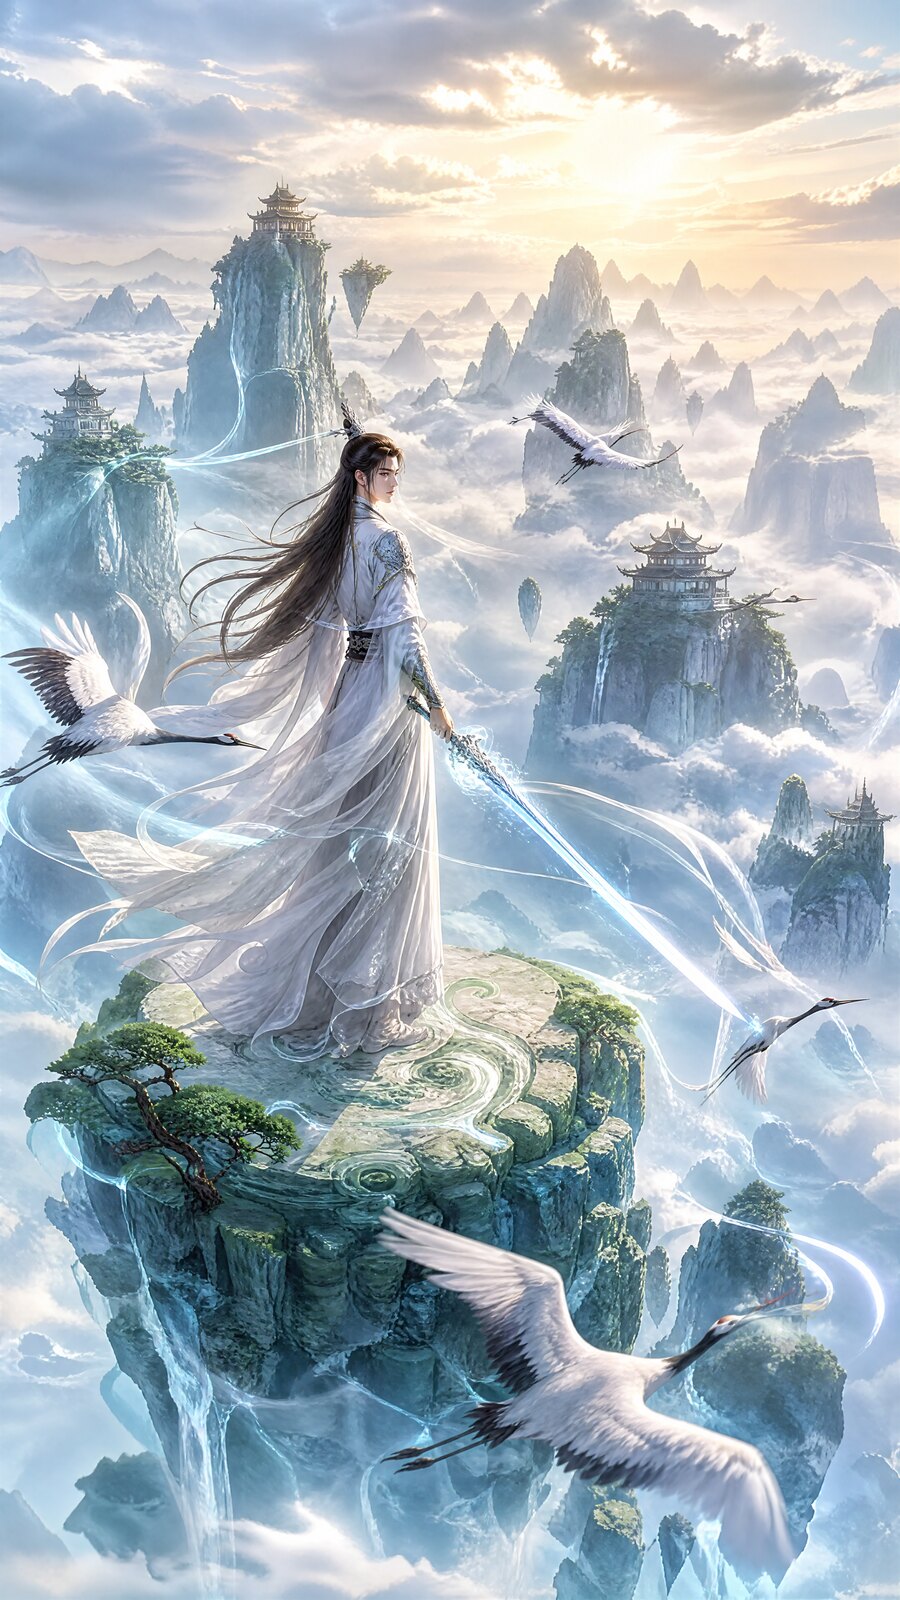
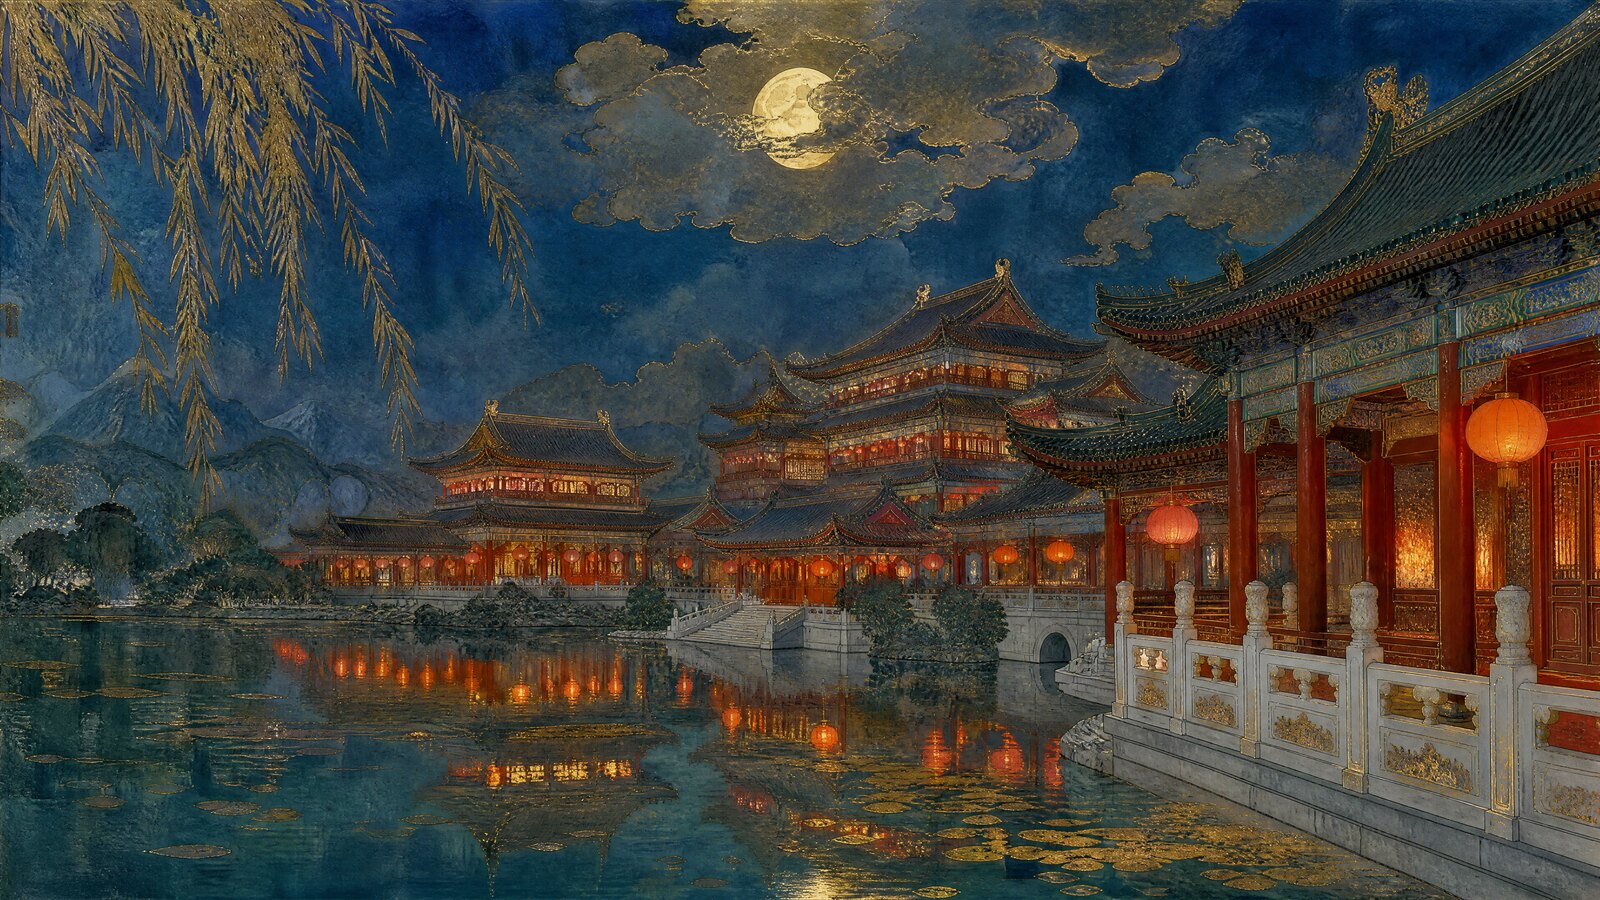
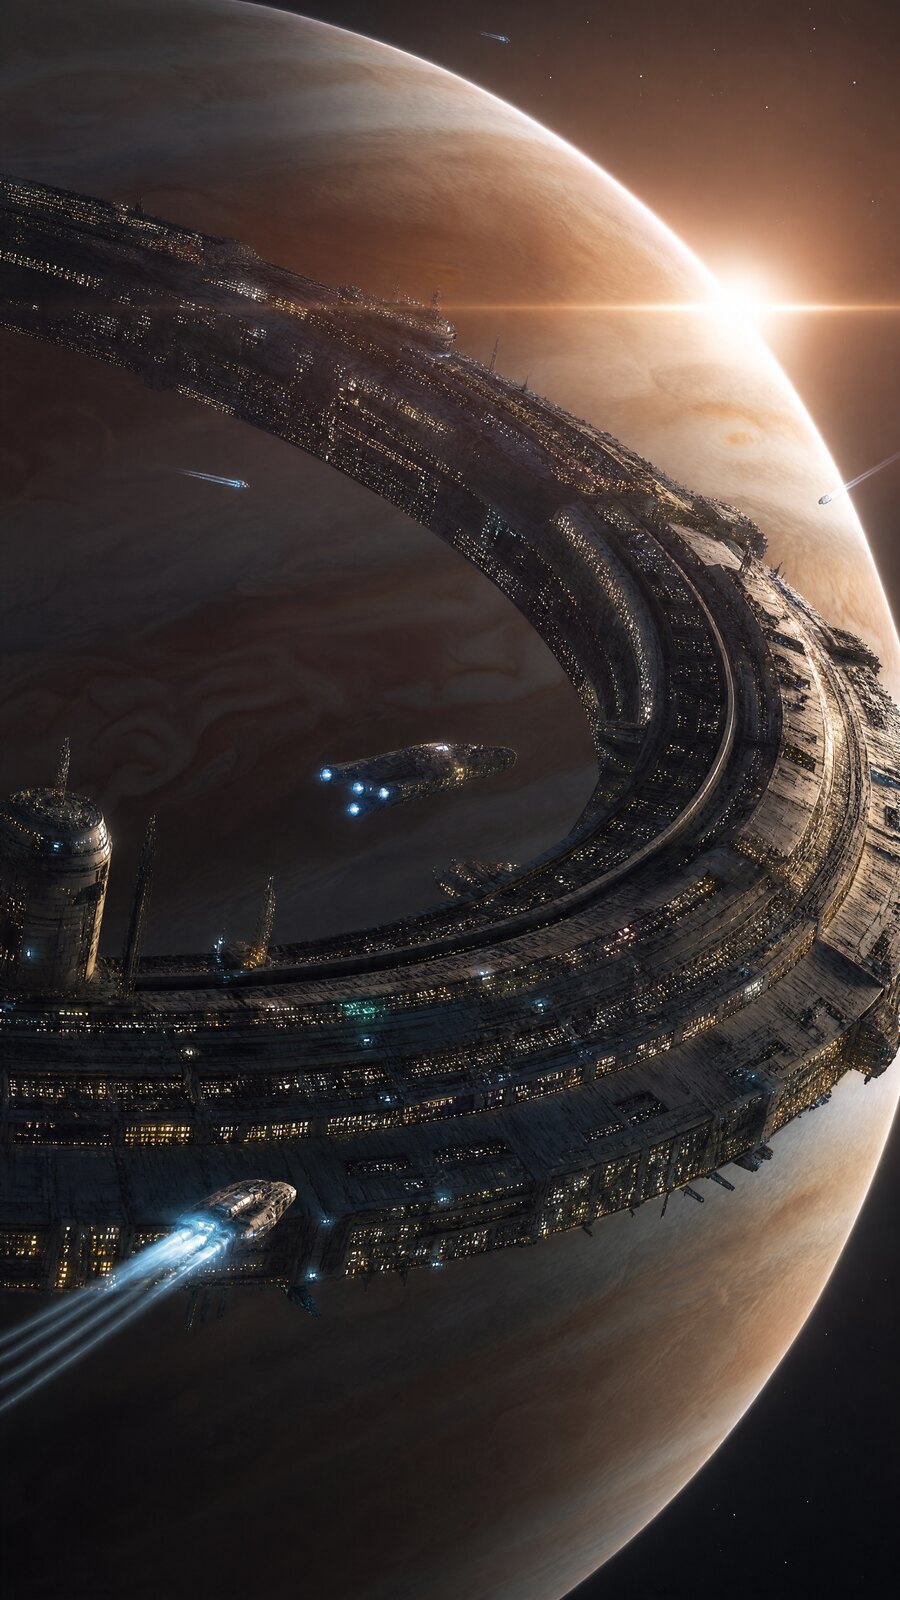
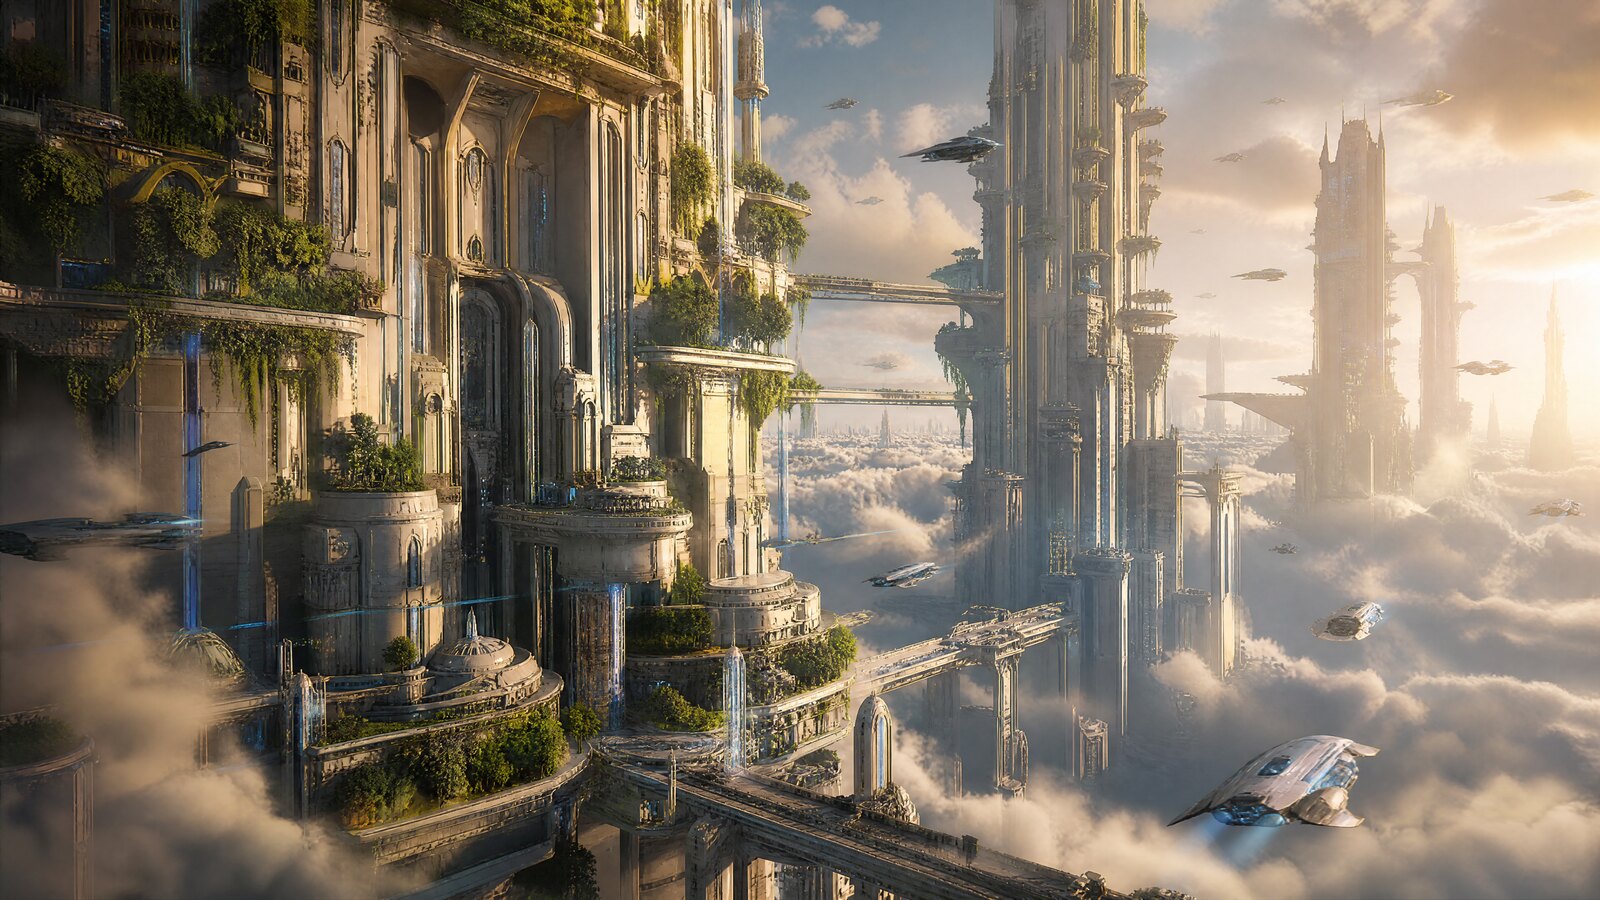
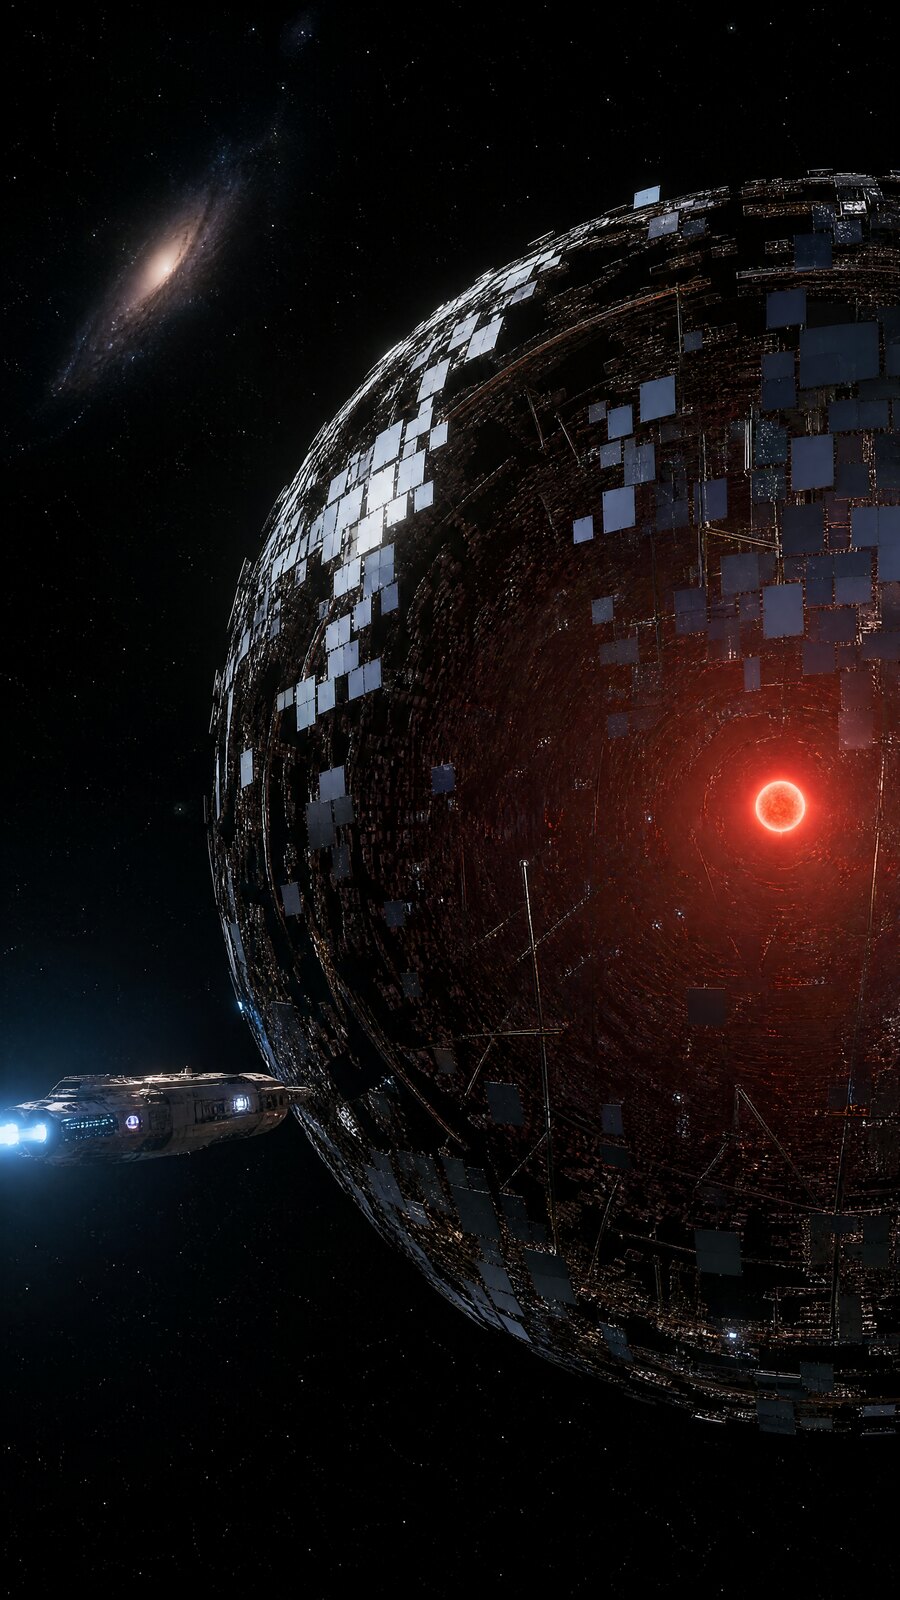
同一批用 edits 做参考图编辑(把水墨图缩到 1920×1080 作为 image[],size=3840x2160、quality=high):50 秒返回精确 4K,构图与笔触完全保留。
其他尺寸与质量档的耗时:low 小图约 20–25 秒,medium 1K 约 80–140 秒,参考图编辑约 50–100 秒。质量越高、图片越大,耗时越长。
错误处理
| 状态 / code | 场景 | 应对 |
|---|---|---|
moderation_blocked | 提示词或图片被内容审核拦截 | 修改提示词或输入图后重试;不要自动重试 |
504 | 同步渲染超时,极少见 | 重试或降一档 quality |
429 | 触发限流 | 指数退避后重试 |
401 / 403 | 鉴权失败或无模型权限 | 检查 API_KEY 与 gpt-image-2 权限 |
审核拦截的响应结构与处理代码见 Responses 页,两套入口相同。
参数速查
model*          gpt-image-2
prompt*         文本描述
size            1024x1024 | 1536x1024 | 1024x1536 | 2048x2048 | 3840x2160 | 2160x3840 | auto
quality         low | medium | high | auto
output_format   png | jpeg | webp
output_compression  0–100                (jpeg / webp)
response_format b64_json | url            (不决定响应形态,两种都要处理)
moderation      auto | low
background      opaque | auto             (transparent 不支持)
n               (无效,恒 1 张)
image[]         edits:一张或多张参考图(multipart)
mask            edits:alpha 蒙版,透明区即重绘区
在线调试
填入你自己的 API Key 即可直接发起请求,参数表与响应结构由接口定义生成。
生成图像(OpenAI 格式)
Authorization
Bearer
In: header
Request Body
application/json
用于图像生成的模型。dall-e-2、dall-e-3 或 gpt-image-1 之一。默认为 dall-e-2,除非使用特定于 gpt-image-1 的参数。
所需图像的文本描述。gpt-image-1 的最大长度为 32000 个字符,dall-e-2 的最大长度为 1000 个字符,dall-e-3 的最大长度为 4000 个字符。
要生成的图像数量。必须介于 1 到 10 之间。对于 dall-e-3,仅支持 n=1。
生成的图像的大小。对于 gpt-image-1,必须是 1024x1024、1536x1024(横向)、1024x1536(纵向)或自动(默认值)之一,对于 dall-e-2,必须是 256x256、``512x512 或 1024x1024 之一,对于 dall-e-3,必须是 1024x1024、1792x1024 或 1024x1792 之一。
允许为生成的图像的背景设置透明度。此参数仅支持 gpt-image-1。必须是以下之一 透明、不透明或自动(默认值)。使用自动时,模型将自动确定图像的最佳背景。
如果是透明的,则输出格式需要支持透明度,因此应将其设置为 png(默认值)或 webp。
控制 gpt-image-1 生成的图像的内容审核级别。必须为低, 以进行限制较少的筛选或自动(默认值)。
将生成的图像的质量。
Response Body
application/json
curl -X POST "https://www.vibeapi.cn/v1/images/generations/" \ -H "Content-Type: application/json" \ -d '{ "prompt": "string" }'{
"created": 0,
"data": [
{
"b64_json": "string",
"url": "string"
}
],
"usage": {
"total_tokens": 0,
"input_tokens": 0,
"output_tokens": 0,
"input_tokens_details": {
"text_tokens": 0,
"image_tokens": 0
}
}
}编辑图像(OpenAI 格式)
Authorization
Bearer
In: header
Request Body
multipart/form-data
要编辑的图像。必须是有效的 PNG 文件,小于 4MB,并且是方形的。如果未提供遮罩,图像必须具有透明度,将用作遮罩。
binary附加图像,其完全透明区域(例如,alpha 为零的区域)指示image应编辑的位置。必须是有效的 PNG 文件,小于 4MB,并且尺寸与原始image相同。
binary所需图像的文本描述。最大长度为 1000 个字符。
要生成的图像数。必须介于 1 和 10 之间。
生成图像的大小。必须是256x256、512x512或 1024x1024之一。
生成的图像返回的格式。必须是url或b64_json。
代表您的最终用户的唯一标识符,可以帮助 OpenAI 监控和检测滥用行为。了解更多。
Response Body
application/json
curl -X POST "https://www.vibeapi.cn/v1/images/edits/" \ -F image="cmMtdXBsb2FkLTE2ODc4MzMzNDc3NTEtMjA=/31225951_59371037e9_small.png" \ -F prompt="A cute baby sea otter wearing a beret."{}